人工智能数据处理 从理论到实践的数据工程指南
在人工智能快速发展的今天,数据被誉为“新时代的石油”。原始数据往往杂乱无章、格式各异,无法直接用于模型训练。数据处理的质量,直接决定了人工智能系统的上限。《人工智能数据处理》(余平等著,电子工业出版社,ISBN:9787121432934)正是为这一关键环节提供系统方法与工程实践的专业教材。该书面向计算机与互联网领域的读者,围绕人工智能场景下的数据获取、清洗、标注、转换与评估展开深入讲解,帮助读者构建完整的数据处理知识体系。
一、人工智能数据处理的核心挑战
与传统数据分析不同,人工智能数据处理面临三大核心挑战。第一是数据规模,海量数据对存储与计算框架提出更高要求;第二是数据质量,缺失值、噪声、重复与不一致数据会影响模型收敛与泛化能力;第三是数据标注,监督学习依赖高质量的标注数据,而人工标注成本高、主观性强。该书从工程视角出发,逐一剖析这些挑战,并给予可落地的解决方案。
二、数据清洗与预处理的关键步骤
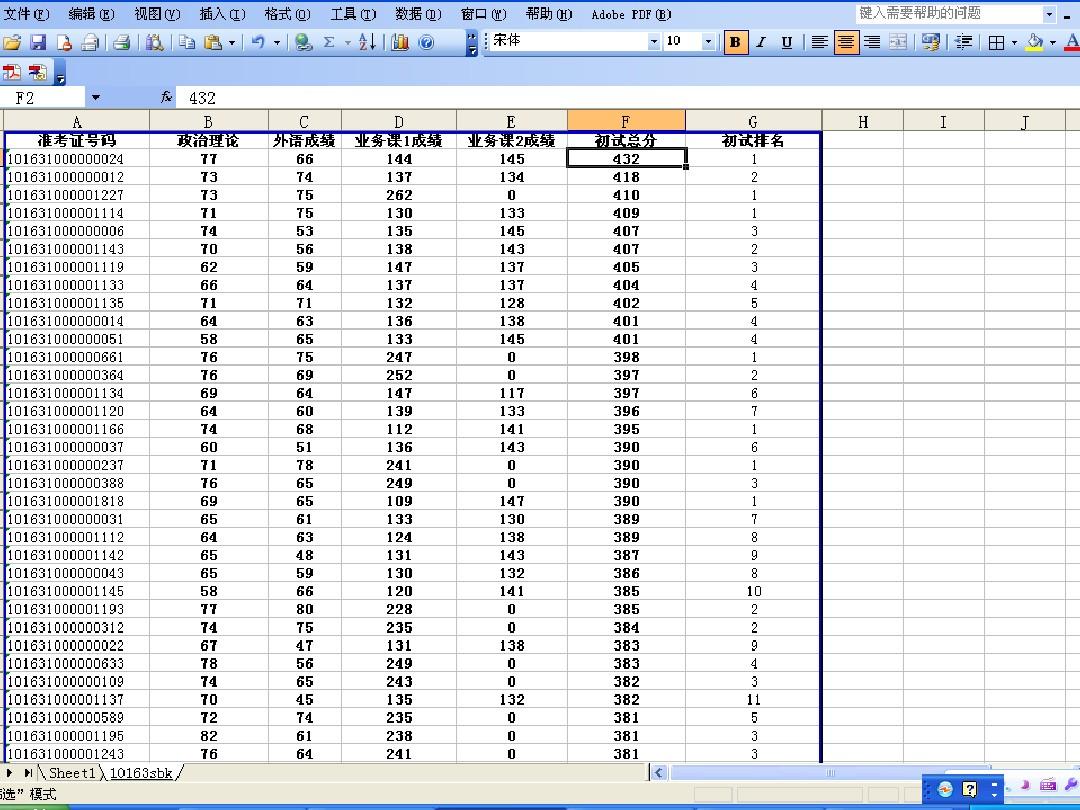
数据清洗是数据处理流程的基石。有效的清洗工作包括:识别和处理缺失值,依据业务含义选择删除、填充或插补策略;检测与修正异常值,结合统计方法与业务规则进行判断;去除重复记录,避免模型过拟合;统一数据格式与单位,确保特征的一致性。在此基础上,数据变换如归一化、标准化、离散化与编码(独热编码、标签编码)进一步为模型提供可用输入。该书通过具体案例,展示如何从原始数据集出发,得到干净、结构化的训练数据。
三、特征工程与数据增强
特征工程是将领域知识融入数据的关键手段。对于表格数据,特征选择与特征构造可以显著提升模型效果;对于文本、图像与语音等非结构化数据,特征提取与表征学习更为重要。与此数据增强技术通过旋转、裁剪、加噪、回译等方式扩充样本,缓解数据不足导致的过拟合问题。全书强调,特征工程与数据增强不是孤立步骤,而应与具体任务与模型类型相适应。
四、数据标注与质量管理
在监督学习场景中,标注数据的质量直接决定模型性能。数据处理流程需要建立标注规范、设计标注工具、实施抽样审核与一致性检查。常用方法包括多人标注交叉验证(如计算标注者间一致性Kappa系数)、主动学习优先标注高价值样本,以及半自动标注结合模型预测与人工修正。书中提出,标注管理应视为一个持续迭代的工程系统,而非一次性任务。专家审核、质量反馈与版本追踪是保障数据质量的有效机制。
五、面向主流AI框架的数据管道实践
理论最终要落实到工程实现。现代人工智能应用常采用TensorFlow、PyTorch等框架,数据处理需要构建端到端的数据管道(Data Pipeline)。典型做法包括使用tf.data实现数据加载、批处理、打乱与预取,提升训练效率;使用PyTorch Dataset与DataLoader定制数据读取逻辑;或者借助Apache Spark、Pandas进行大规模预处理。数据版本管理与血缘追踪则保障实验可复现和结果可追溯。该书配套的实际案例展示了完整的数据管道搭建过程,覆盖从CSV读取、清洗、划分训练/验证/测试集到送入模型的整个链条。
六、
人工智能数据处理是一项融汇数据工程、统计学与机器学习知识的综合性技能。《人工智能数据处理》(余平等著,电子工业出版社,9787121432934)以平实的语言与丰富的示例,系统阐述了数据处理的标准流程、工具方法与质量保障策略。对于计算机与互联网领域的从业者而言,本书不仅是入门读物,更是实践中处理数据问题时随时翻阅的技术参考。在人工智能项目里,处理好数据,往往就等于成功了一半;阅读本书、并在项目中践行其方法思想,值得每一位数据工程师认真对待。